DeepSeek V4.1 Flash 1017 划算嗎?用任務成本看這次更新
- DeepSeek 這次更新有個值得注意的變化:在 Artificial Analysis 的評測裡,新版智力指數從 39 升到 45,每項任務的平均費用卻從 0.57 降到 0.26 美元,輸入與輸出單價都沒有調降。
- 預算差不多時,新版比 GLM-5.3-Flash 少花一點錢、綜合分數也較高;若和同為 45 分的 GLM-5.3 max 比,每項任務是 0.26 對 2.01 美元。不過,GLM-5.3 max 在終端機程式測驗的通過率仍較高。
- 有網友拿新版做網頁動畫,第一次花了錢卻沒有成品,調低推理投入後才完成。這個經過提醒我們,評測裡的低成本之外,還得看實際工作能否交付。
DeepSeek 這次更新了什麼?
DeepSeek 在 10 月 17 日推出 V4.1 Flash 1017,官網、App 和 API 都已開放使用。
這是 V4.1 Flash 的更新版,官方把改進重點放在推理、寫程式,以及 Agent 使用工具的能力。
搭配模型工作的 DeepSeek Harness 也一起調整了,也就是協助模型讀取檔案、執行工具及處理任務的環境。
如果你原本透過官方 API 呼叫 deepseek-flash,現在接到的就是這次更新,不必換模型代號。
官方表示,新版回答更精簡、完成任務更快。
但換到實際工作,這些改進能不能變成更划算的成果?
有位網友做網頁動畫的經過,剛好讓我們看到發布說明之外的另一面。
同一份動畫需求,為什麼先失敗、後來才完成?
Reddit 有位使用者想做一個 HTML 網頁,用 5 個場景播放虛構電子紙筆記本的 10 秒上市動畫。
他從 Claude Code 經由 Atlas Cloud 呼叫模型,把同一份需求交給 3 個模型比較。
其中,DeepSeek 新版第一次把那次回覆的 16,000 個 Token 額度全用在思考,沒有輸出成品,卻仍收了 0.019 美元。
後來他把 reasoning_effort,也就是推理投入程度,調成 low,才拿到完成的網頁,這次費用是 0.016 美元。
依他的分享,DeepSeek 是這次比較中唯一做齊 5 個場景的模型。
不過,只看成功那次的 0.016 美元,會漏掉前一次已經付費、卻沒有拿到成果的經過。
這兩筆是他經由第三方服務執行特定工作的帳單。
要比較新版與其他模型的成本,還可以看固定評測題目下的結果,才不會把不同工作、不同設定的費用放在一起算。
單價沒降,怎麼每項任務的費用反而少了?
Artificial Analysis 比較 DeepSeek 新舊版時,兩者都採 max 推理設定。
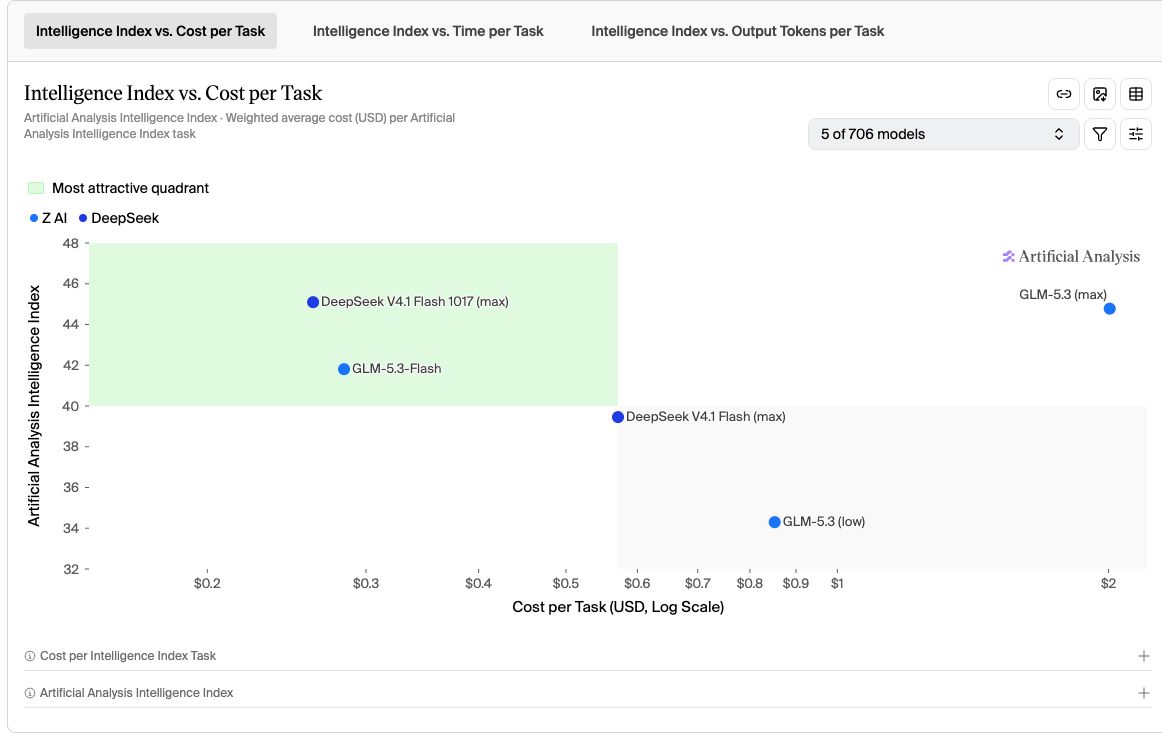
新版的智力指數是 45 分,舊版是 39 分;加權平均每項評測任務的費用,則從 0.57 美元降到 0.26 美元。
兩版列出的輸入與輸出單價相同,所以這次看到的省錢,沒有反映在每百萬 Token 的價目表上。
差別要看完成整項任務後的費用。
AA 會把輸入、快取、推理與回答的用量一起計入成本,再按不同測驗的權重整理。
因此,即使單價相同,跑完一組任務的帳單仍可能不同。
對想把工作交給 Agent 的人來說,這比單看 Token 價格,更接近「拿到成果要付多少」的問題。
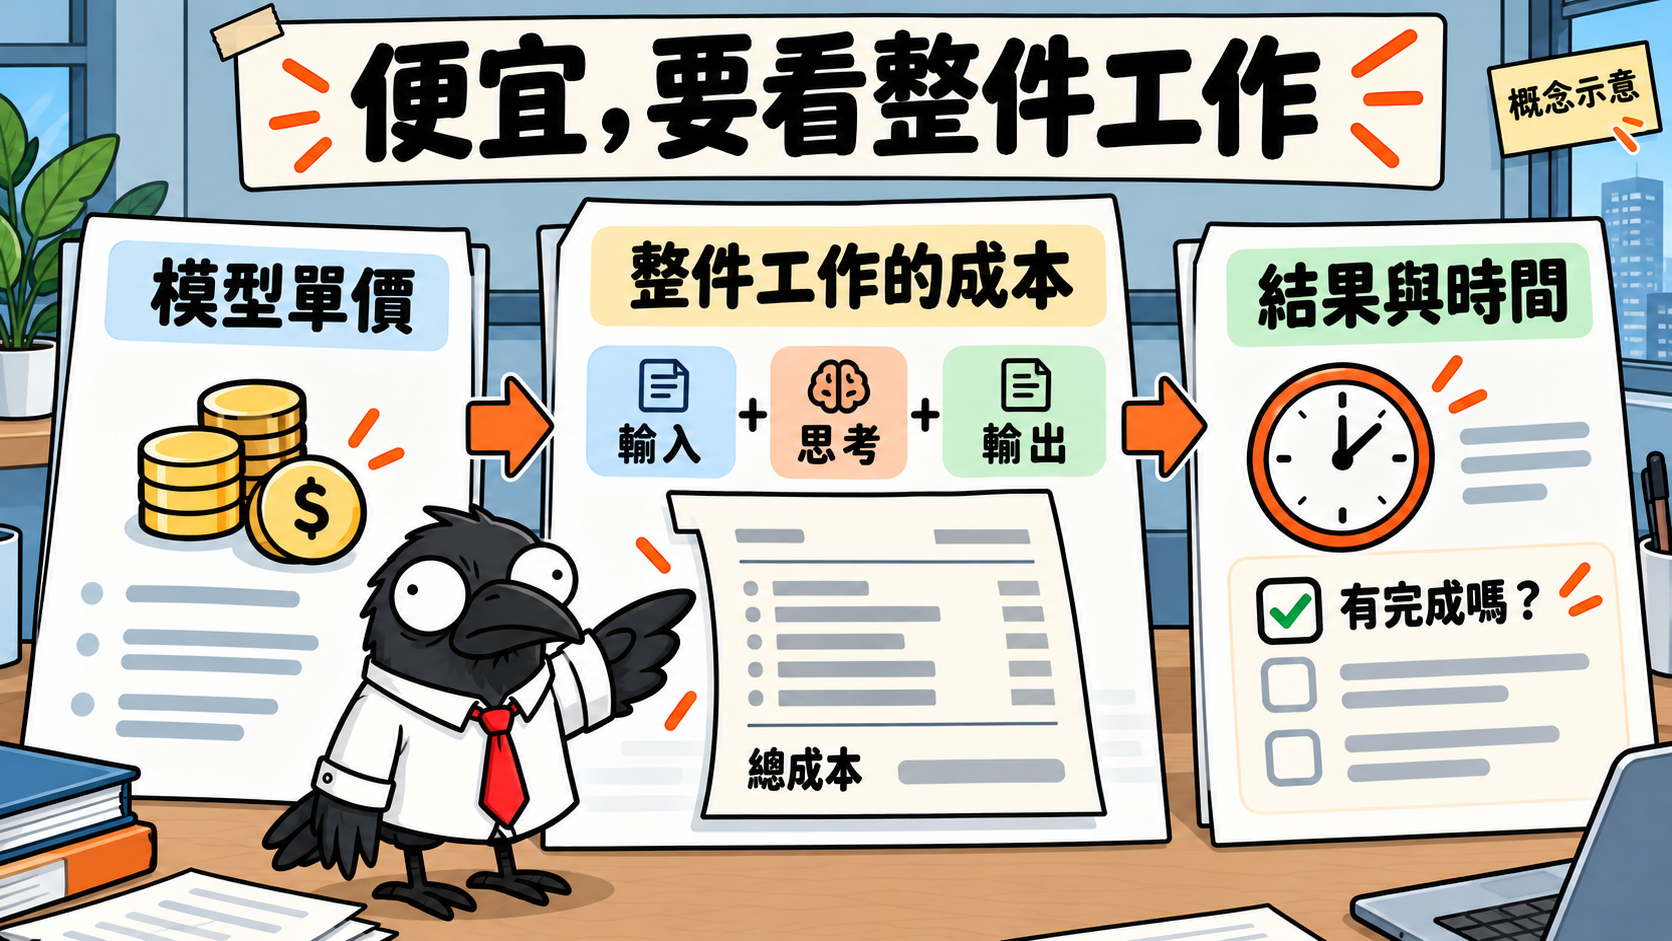
模型單價、整項工作成本與成果的關係,Raven 概念示意。
這裡的 0.26 美元是評測題目的平均費用。
換成你的文件、對話紀錄與工作內容,實際用量仍會不同;它適合用來看同一組測試裡各模型的相對位置。
預算差不多,和 GLM 比起來怎麼選?
先看價位接近的 GLM-5.3-Flash:它的智力指數是 42 分,每項評測任務平均 0.28 美元;DeepSeek 新版是 45 分、0.26 美元。
在這組測試裡,DeepSeek 用稍低的費用拿到較高的綜合分數。
如果想找綜合能力接近的對手,GLM-5.3 max 同樣是 45 分,平均每項任務卻要 2.01 美元。
DeepSeek 的成本優勢,在這個比較下就更明顯了。
不過,智力指數是把 10 項測驗整理成一個分數,包含知識、推理、程式與文件工作。
總分相同,各項工作的表現仍可能有差,所以還要回到你準備交給模型的任務。
例如工作會用到終端機、需要 Agent 修改程式,就可以看 Terminal-Bench 4.0 的任務通過率。
在這項測驗中,DeepSeek 新版是 34%,舊版是 27%;GLM-5.3 max 是 42%,GLM-5.3-Flash 是 33%。
因此,同樣拿到 45 分的 DeepSeek 與 GLM-5.3 max,在這類程式任務上仍有差距。
這也說明,較便宜的綜合能力,和某項工作做得較好,是兩個要分開看的問題。
同價位比較裡,DeepSeek 與 GLM-5.3-Flash 的這項通過率相近;若改看 GLM-5.3 max,花費提高的同時,這項測驗的通過率也較高。
推理設定同樣會改變比較結果。
GLM-5.3 從 max 改為 low,智力指數由 45 變成 34,平均任務費用由 2.01 變成 0.85 美元。
上面的 DeepSeek 新舊版及 GLM-5.3 比較採 max;GLM-5.3-Flash 在 AA 頁面沒有另標推理設定。
費用少了,生成文字也變快了嗎?
看完費用,再看同一組評測的文字生成時間:DeepSeek 新版平均每項任務約 5 分鐘,舊版約 4.8 分鐘。
GLM-5.3 max 約 9.6 分鐘,GLM-5.3-Flash 約 11.7 分鐘。
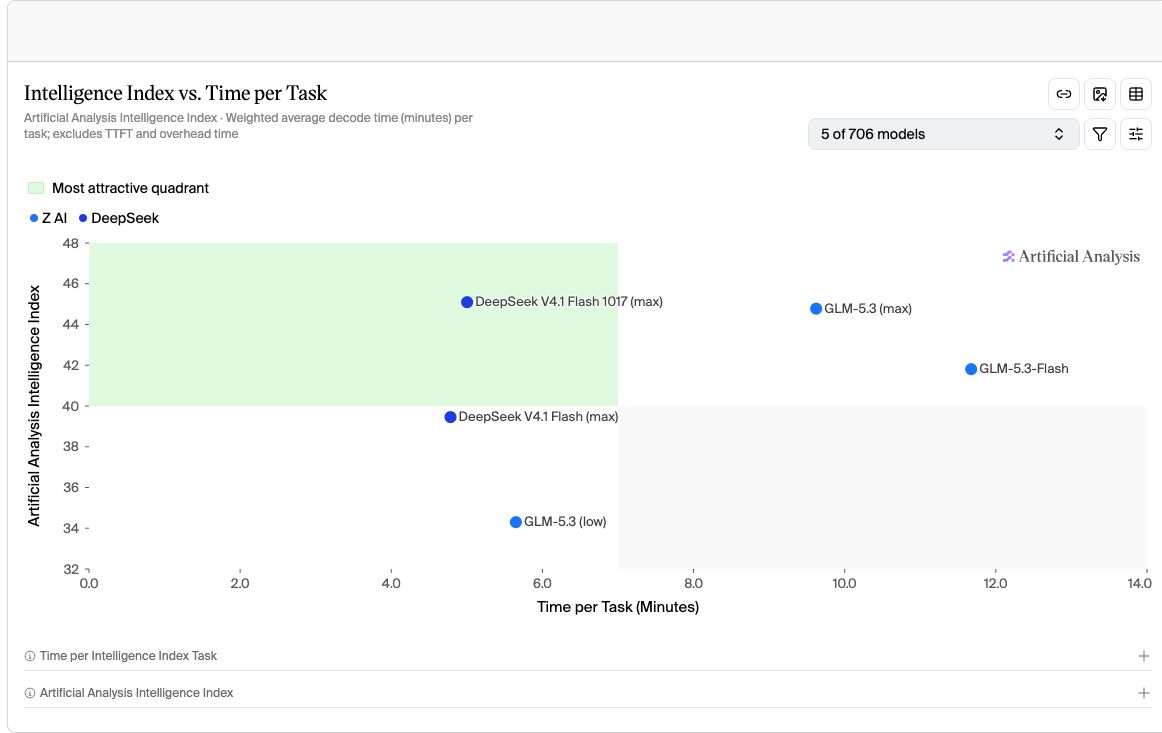
也就是說,DeepSeek 新版相較舊版,改善的是這組測試裡的分數與費用,文字生成時間並沒有一起縮短。
圖中的時間只計算模型生成文字,不包含工具執行等額外等待。
如果工作還要讀檔、執行程式或反覆修正,整個 Agent 流程的耗時就得另外觀察;不能直接把圖上的分鐘數當成交件時間。
DeepSeek 的 CP 值,這次可以怎麼看?
如果你在意的是相近預算下的綜合能力,這次 DeepSeek 的結果值得留意:比 GLM-5.3-Flash 稍便宜、分數較高,和舊版相比也有改善。
如果主要工作是操作終端機與修改程式,則要把 GLM-5.3 max 較高的任務通過率,和它較高的成本一起考慮。
網友的動畫案例也補上一件評測表不會替你決定的事:實際使用時,推理設定與有沒有拿到成品,都會影響這筆錢花得值不值得。
所以這次更新的收穫,不只是知道 DeepSeek 便宜,而是能分清楚它便宜在哪裡:固定評測中的平均任務成本下降,綜合分數提高,文字生成時間則沒有比舊版縮短。
把這些差異對照手上的工作,才有辦法判斷這個低價模型是不是適合你的選擇。